Книги и авторы: повторяем замер 2018 года на ядре Интеграм
Миллион книг, 143 тысячи авторов, обычная схема MySQL против единой таблицы ядра. Повторили замер 2018 года, добавили агрегаты и честные индексы — где ядро не уступает, а где агрегаты лучше считать заранее.
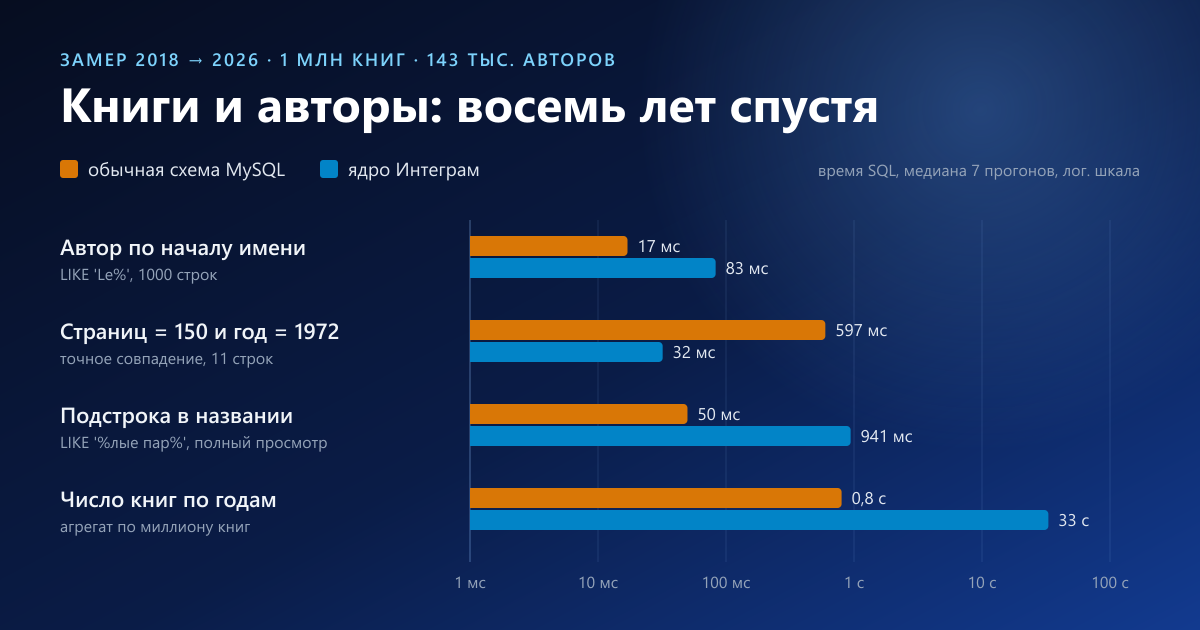
В 2018 году мы опубликовали на Хабре замер «книги и авторы»: миллион книг и 143 тысячи авторов в обычной схеме MySQL и те же данные в единой таблице конструктора. Вывод тогда был такой: на простых выборках конструктор медленнее примерно в полтора раза, и пользователь этой разницы не заметит.
С тех пор сменились MySQL, железо и само ядро. Мы повторили замер на сегодняшней версии и добавили то, чего в 2018 году не было:
- три запроса-агрегата: книги по годам, сумма страниц по автору, топ-10 авторов;
- честную индексацию обычной схемы: индексы, которые поставил бы любой DBA, а не только те, что были в исходной статье.
Стенд и данные
- MySQL 8.0, контейнер с ограничением 2 CPU и 2 ГБ памяти, буферный пул InnoDB 128 МБ.
- Данные синтетические, генератор с фиксированным зерном: 1 048 552 книги и 142 654 автора, как в 2018 году. У книги есть название, автор, число страниц (20–1000) и год (1950–2025).
- Обычная схема — таблицы
authorиbooks, 190 МБ. - В ядре те же данные лежат в одной таблице
id, t, up, ord, valс индексами(up, t)и(t, val): 4,3 млн строк, 485 МБ. - Запрос к ядру — обычный отчёт, вызванный через HTTP API, как его вызывает интерфейс. Отдельно мы снимали время самого SQL, который строит ядро. Разница между ними — 30–55 мс на каждый ответ: проверка токена, прав и метаданных.
- Каждый запрос выполнялся 7 раз, в таблицах — медианы.
Скрипты генерации, схемы, отчёты и замерщик открыты: стенд поднимается одной командой, цифры воспроизводятся.
Выборки по индексу: разница меньше, чем время отклика интерфейса
Поиск автора по подстроке, по началу имени и по точному совпадению с выводом его книг:
| Условие на автора | Строк | Обычная схема, мс | Ядро, SQL, мс | Ядро, HTTP, мс |
|---|---|---|---|---|
LIKE '%aro%' | 1000 | 29 | 140 | 191 |
LIKE 'Le%' | 1000 | 17 | 83 | 135 |
LIKE 'Мун %' | 495 | 8 | 39 | 96 |
LIKE 'Co %' | 395 | 5 | 20 | 62 |
LIKE 'Te %' | 229 | 4 | 15 | 59 |
LIKE 'Wij%' | 108 | 2 | 9 | 57 |
LIKE 'Тяме%' | 66 | 2 | 6 | 45 |
= 'Иванов' | 11 | 0,7 | 1,5 | 30 |
= 'Brait' | 6 | 0,7 | 1,3 | 31 |
На SQL ядро медленнее в 2–5 раз, в 2018 году было в 1,5 раза. Ядро не стало медленнее: обычная схема на сегодняшнем MySQL и железе ускорилась сильнее. Порядок величин тот же, что и тогда: десятки миллисекунд на ответ с тысячей строк. В интерфейсе это неотличимо от мгновенного.
Подстрока в названии книги: полный просмотр у обеих схем
Запрос книга LIKE '%лые пар%', первые 50 совпадений. Индекс здесь не помогает никому, поэтому обе схемы просматривают данные до 50-го совпадения:
| Вариант | Обычная схема, мс | Ядро, SQL, мс | Ядро, HTTP, мс |
|---|---|---|---|
| отчёт начинается с автора | 50 | 941 | 928 |
| отчёт начинается с книги | 48 | 1 698 | 1 485 |
Обычная схема читает компактную таблицу books. Ядро читает строки всех реквизитов, а их в 4 раза больше. В 2018 году вариант «книга первой» у конструктора занял 25 мс. Время такого запроса зависит от того, где в таблице лежат первые 50 совпадений. В наших синтетических данных они рассыпаны равномерно, поэтому просматривать приходится заметную часть таблицы.
Практический вывод: поиск по подстроке в середине текста по миллиону записей занимает 1–2 секунды. Для поля поиска в интерфейсе это терпимо. Если такой поиск идёт постоянно, его стоит ограничить другими условиями или искать по началу слова.
Точное совпадение по числам: всё решает индекс
Книги, где страниц = 150 и год = 1972, 11 строк:
| Схема | Время |
|---|---|
обычная, индексы как в 2018 году (name, author) | 597 мс |
обычная + индекс (year, pages) | 0,8 мс |
| ядро, SQL | 32 мс |
| ядро, HTTP | 79 мс |
В 2018 году этот запрос дал конструктору выигрыш больше чем в 30 раз. На тех же индексах выигрыш сохраняется: на SQL ядро быстрее примерно в 19 раз, с учётом HTTP-ответа — в 7,5 раза. Причина в том, что индекс (t, val) есть у ядра для любого реквизита, а обычной схеме индекс по каждому полю нужно ставить руками. Когда DBA ставит индекс под конкретный запрос, обычная схема отвечает за миллисекунду. Ядро же даёт приемлемое время на любом реквизите без DBA.
Агрегаты по всей таблице: считать заранее
Новые запросы, которых не было в 2018 году. Индексы обычной схемы во втором столбце — (year, pages) и (author, pages):
| Запрос | Обычная, индексы 2018, с | Обычная + индексы, с | Ядро, SQL, с | Ядро, HTTP, с |
|---|---|---|---|---|
| число книг по годам, 76 строк | 0,8 | 0,3 | 33 | 36 |
| сумма страниц по каждому автору, 142 654 строки | 23 | 8,9 | 54 | 58 |
| топ-10 авторов по числу книг | 7,9 | 7,7 | 53 | 49 |
Здесь разница уже существенная: в 6–7 раз для агрегатов по авторам и больше чем в 100 раз для группировки по году. Агрегат по миллиону объектов ядро собирает из строк реквизитов: для каждой книги нужно найти строку года или страниц, а это 1–3 млн обращений по индексу. Обычная схема читает одну узкую таблицу или даже один индекс.
Но и обычной схеме 8–9 секунд на сумму страниц по всем авторам — не время для отчёта, который открывают в интерфейсе. На таких объёмах обе схемы приходят к одному решению: итог считается заранее (по расписанию или при изменении данных) и хранится отдельно, а отчёт читает готовые цифры. Об этом же говорила статья 2018 года: на очень больших объёмах нужны те же меры, что и в традиционных базах.
Что изменилось за восемь лет
- Выборки по индексу. Ядро по-прежнему отвечает за десятки миллисекунд. Разница с обычной схемой в разах выросла, потому что обычная схема на современном железе ускорилась сильнее. В абсолютных цифрах разница пользователю не видна.
- Условия на любые реквизиты. Ядро быстро отвечает без отдельной настройки: индекс
(t, val)уже покрывает любой реквизит. Обычная схема догоняет и обгоняет ядро, только когда под запрос поставили свой индекс. - Полный просмотр (подстрока в середине текста). Ядро медленнее обычной схемы в 20–35 раз, в абсолютных цифрах это 1–2 секунды на миллион записей.
- Агрегаты по всей таблице. Ядро медленнее в 6–100 раз. Для отчётов по миллионам записей итоги нужно готовить заранее, и это верно для любой схемы.
Конструктор по-прежнему не вызывает критической деградации на типовых операциях: поиск, карточка, список с фильтрами. Там, где задача упирается в объём, а не в устройство схемы, рецепты общие для всех баз данных.