Рекурсия на сервере: как Интеграм обходит деревья и графы одним запросом
Большинство бизнес-данных — это связи: подразделение внутри подразделения, «похожие» записи одна за другой. Чтобы пройти такую структуру вглубь, обычно идут в код приложения — десятки запросов. Интеграм обходит дерево или граф и сразу ранжирует результат за один серверный вызов.

Большинство бизнес-данных — это не плоские таблицы, а связи: подразделение внутри подразделения, категория внутри категории, «похожие» записи, тянущиеся одна за другой. Чтобы пройти такую структуру вглубь — от корня до листьев или от записи к её соседям — нужна рекурсия. Обычно за ней идут в код приложения: выгрузил один уровень, спросил следующий, и так десятки раз. Каждый шаг — отдельное обращение к серверу.
Интеграм умеет иначе: обойти всю структуру вглубь и сразу её отсортировать — за один серверный вызов.
Откуда берётся рекурсия
Движок отчётов Интеграма опирается на нативный механизм MySQL WITH RECURSIVE — стандартный способ писать рекурсивные запросы прямо в СУБД. Поверх него работает композиция: запись вида [имя_отчёта] подставляет один сохранённый отчёт внутрь другого как подзапрос. Вы собираете сложный обход из простых кирпичиков-отчётов, а сервер разворачивает его в один SQL-запрос. Никакого отдельного «движка обхода» и никакой выгрузки промежуточных уровней в приложение.
Как именно это делается: функция RECURSIVE
Рекурсия в Интеграме — это не отдельный тип объекта и не скрипт, а одна настройка обычной колонки запроса.
Шаг 1. Колонка с функцией RECURSIVE
В редакторе запроса у каждой колонки есть поле «Функция» — тот же список, откуда берутся SUM, COUNT, abn_ID. Среди них есть значение RECURSIVE. Поставьте его на первую колонку запроса, и движок перестаёт собирать для этого запроса обычный SELECT с джойнами — он целиком заменяет его рекурсивным CTE. Именно поэтому рекурсивный запрос делают маленьким и отдельным: у него ровно одна колонка, и его единственная работа — вернуть список ID обойдённых записей.
Источник этой колонки (поле «Таблица/реквизит») задаёт, что обходим: таблицу, по которой пойдёт спуск, или ссылочный реквизит, по которому пойдёт обход графа.
Шаг 2. Зерно — откуда начинать
Обход должен с чего-то начаться. Стартовый набор («зерно») задаётся полем колонки «Значение (от)», и вариантов три:
[имя_другого_отчёта]— зерном становится результат вложенного запроса. Движок собирает SQL подзапроса (не выполняя его) и подставляет условиеAND id IN (…). Это основной рабочий вариант.- внешний фильтр в URL —
report/{имя}?FR_{имя_колонки}={значение}: зерно приходит параметром вызова. - пусто — зерном становится вся таблица.
Шаг 3. Что движок пишет в SQL
Здесь помогает устройство хранилища: все записи всех таблиц Интеграма лежат в одной физической таблице (она называется по имени базы) с колонками id, up (родитель), t (тип), val (значение). Поэтому один и тот же шаблон CTE работает для любого дерева и любого графа — меняется только шаг рекурсии.
Сгенерированный SQL можно увидеть своими глазами: в самой базе — Файлы → templates → logs → trace.log, там лежит последний выполненный запрос. Ниже — настоящий текст оттуда, а не пересказ.
Вариант А — дерево подчинённых таблиц (запись подчинена записи, спуск от родителя к детям). Это буквально то, во что превращается запрос rec из примера ниже:
WITH RECURSIVE c AS (
    SELECT id, 0 t FROM ateh
     WHERE t=151 AND up!=0 AND t!=up AND val!=''
       AND id IN (SELECT a329_151_id                       -- ← вложенный запрос-зерно
                    FROM ateh a329_18
                    LEFT JOIN (SELECT r329_42.up, a329_42.id a329_42_id
                                 FROM ateh r329_42, ateh a329_42 USE INDEX (PRIMARY)
                                WHERE a329_42.id=r329_42.t AND a329_42.t=42) a329_42
                           ON a329_42.up=a329_18.id
                    LEFT JOIN (SELECT a329_151.up, a329_151.id a329_151_id
                                 FROM ateh a329_151
                                WHERE a329_151.t=151) a329_151
                           ON a329_151.up=a329_42_id
                   WHERE a329_18.up!=0 AND a329_18.t!=a329_18.up
                     AND length(a329_18.val)!=0 AND a329_18.t=18
                     AND a329_18.id=462)
  UNION
    SELECT ref.id id, ref.t FROM ateh ref
     INNER JOIN c ON c.id=ref.up                           -- ← дети тех, кто уже в наборе
     WHERE ref.t=151
     LIMIT 80
)
SELECT DISTINCT id 'Меню' FROM c
Расшифровка: ateh — имя базы и одновременно имя таблицы объектов; 151 — тип «Меню», 42 — «Роль», 18 — «Пользователь»; 462 — id текущего пользователя, который движок подставил вместо [USER_ID]; алиасы a329_* собраны из запроса №329 — того самого [myMenus], что стоял в поле «Значение (от)».
Вариант Б — граф по ссылочному реквизиту (от записи к тем, что связаны с ней ссылкой). Отличается только шагом рекурсии — якорь и обёртка те же:
  UNION
    SELECT ref.up id, ref.t FROM mem ref
     INNER JOIN c ON c.id=ref.t        -- связанные ссылкой с тем, кто уже в наборе
     WHERE ref.val = '<реквизит-ссылка>'
     LIMIT 80
Первая часть CTE (до UNION) — якорь: зерно. Вторая — шаг рекурсии: он берёт то, что уже накоплено в c, и добавляет соседний слой. СУБД повторяет шаг, пока он даёт новые строки.
Шаг 4. Бюджет и защита от циклов
Две детали, которые делают это безопасным на боевых данных:
UNION, а неUNION ALL. Дубликаты схлопываются, поэтому граф с циклами («A ссылается на B, B — обратно на A») не зацикливает обход: повторно пришедшая запись просто не добавляет новых строк.LIMITвнутри шага рекурсии — бюджет обхода, по умолчанию 80 записей на фронт. Переопределяется параметром?LIMIT=при вызове. Сверху остаётся и штатный предохранитель MySQLcte_max_recursion_depth(по умолчанию 1000).
Шаг 5. Использовать результат
Рекурсивный запрос отдаёт один столбец ID — и дальше он подставляется в любой другой запрос через те же квадратные скобки: IN([rec]) в формуле, в фильтре, в условии джойна. Подстановка рекурсивна: вложенный запрос может сам содержать вложенные. На выходе получается один SQL-statement, который СУБД выполняет за один проход.
Кейс 1. Деревья: как устроено ролевое меню самого Интеграма
Лучший пример — тот, что есть в любой базе Интеграма: меню, которое пользователь видит согласно своей роли. Это три запроса, вложенные один в другой.
myMenus — зерно. Мастер-таблица «Пользователь», колонка отфильтрована по [USER_ID] (текущий пользователь), дальше джойн на «Роль» и на «Меню». Колонки пользователя и роли скрыты (переключатель-«глаз» в шапке), поэтому в SELECT остаётся ровно один столбец — то, что и нужно подзапросу.
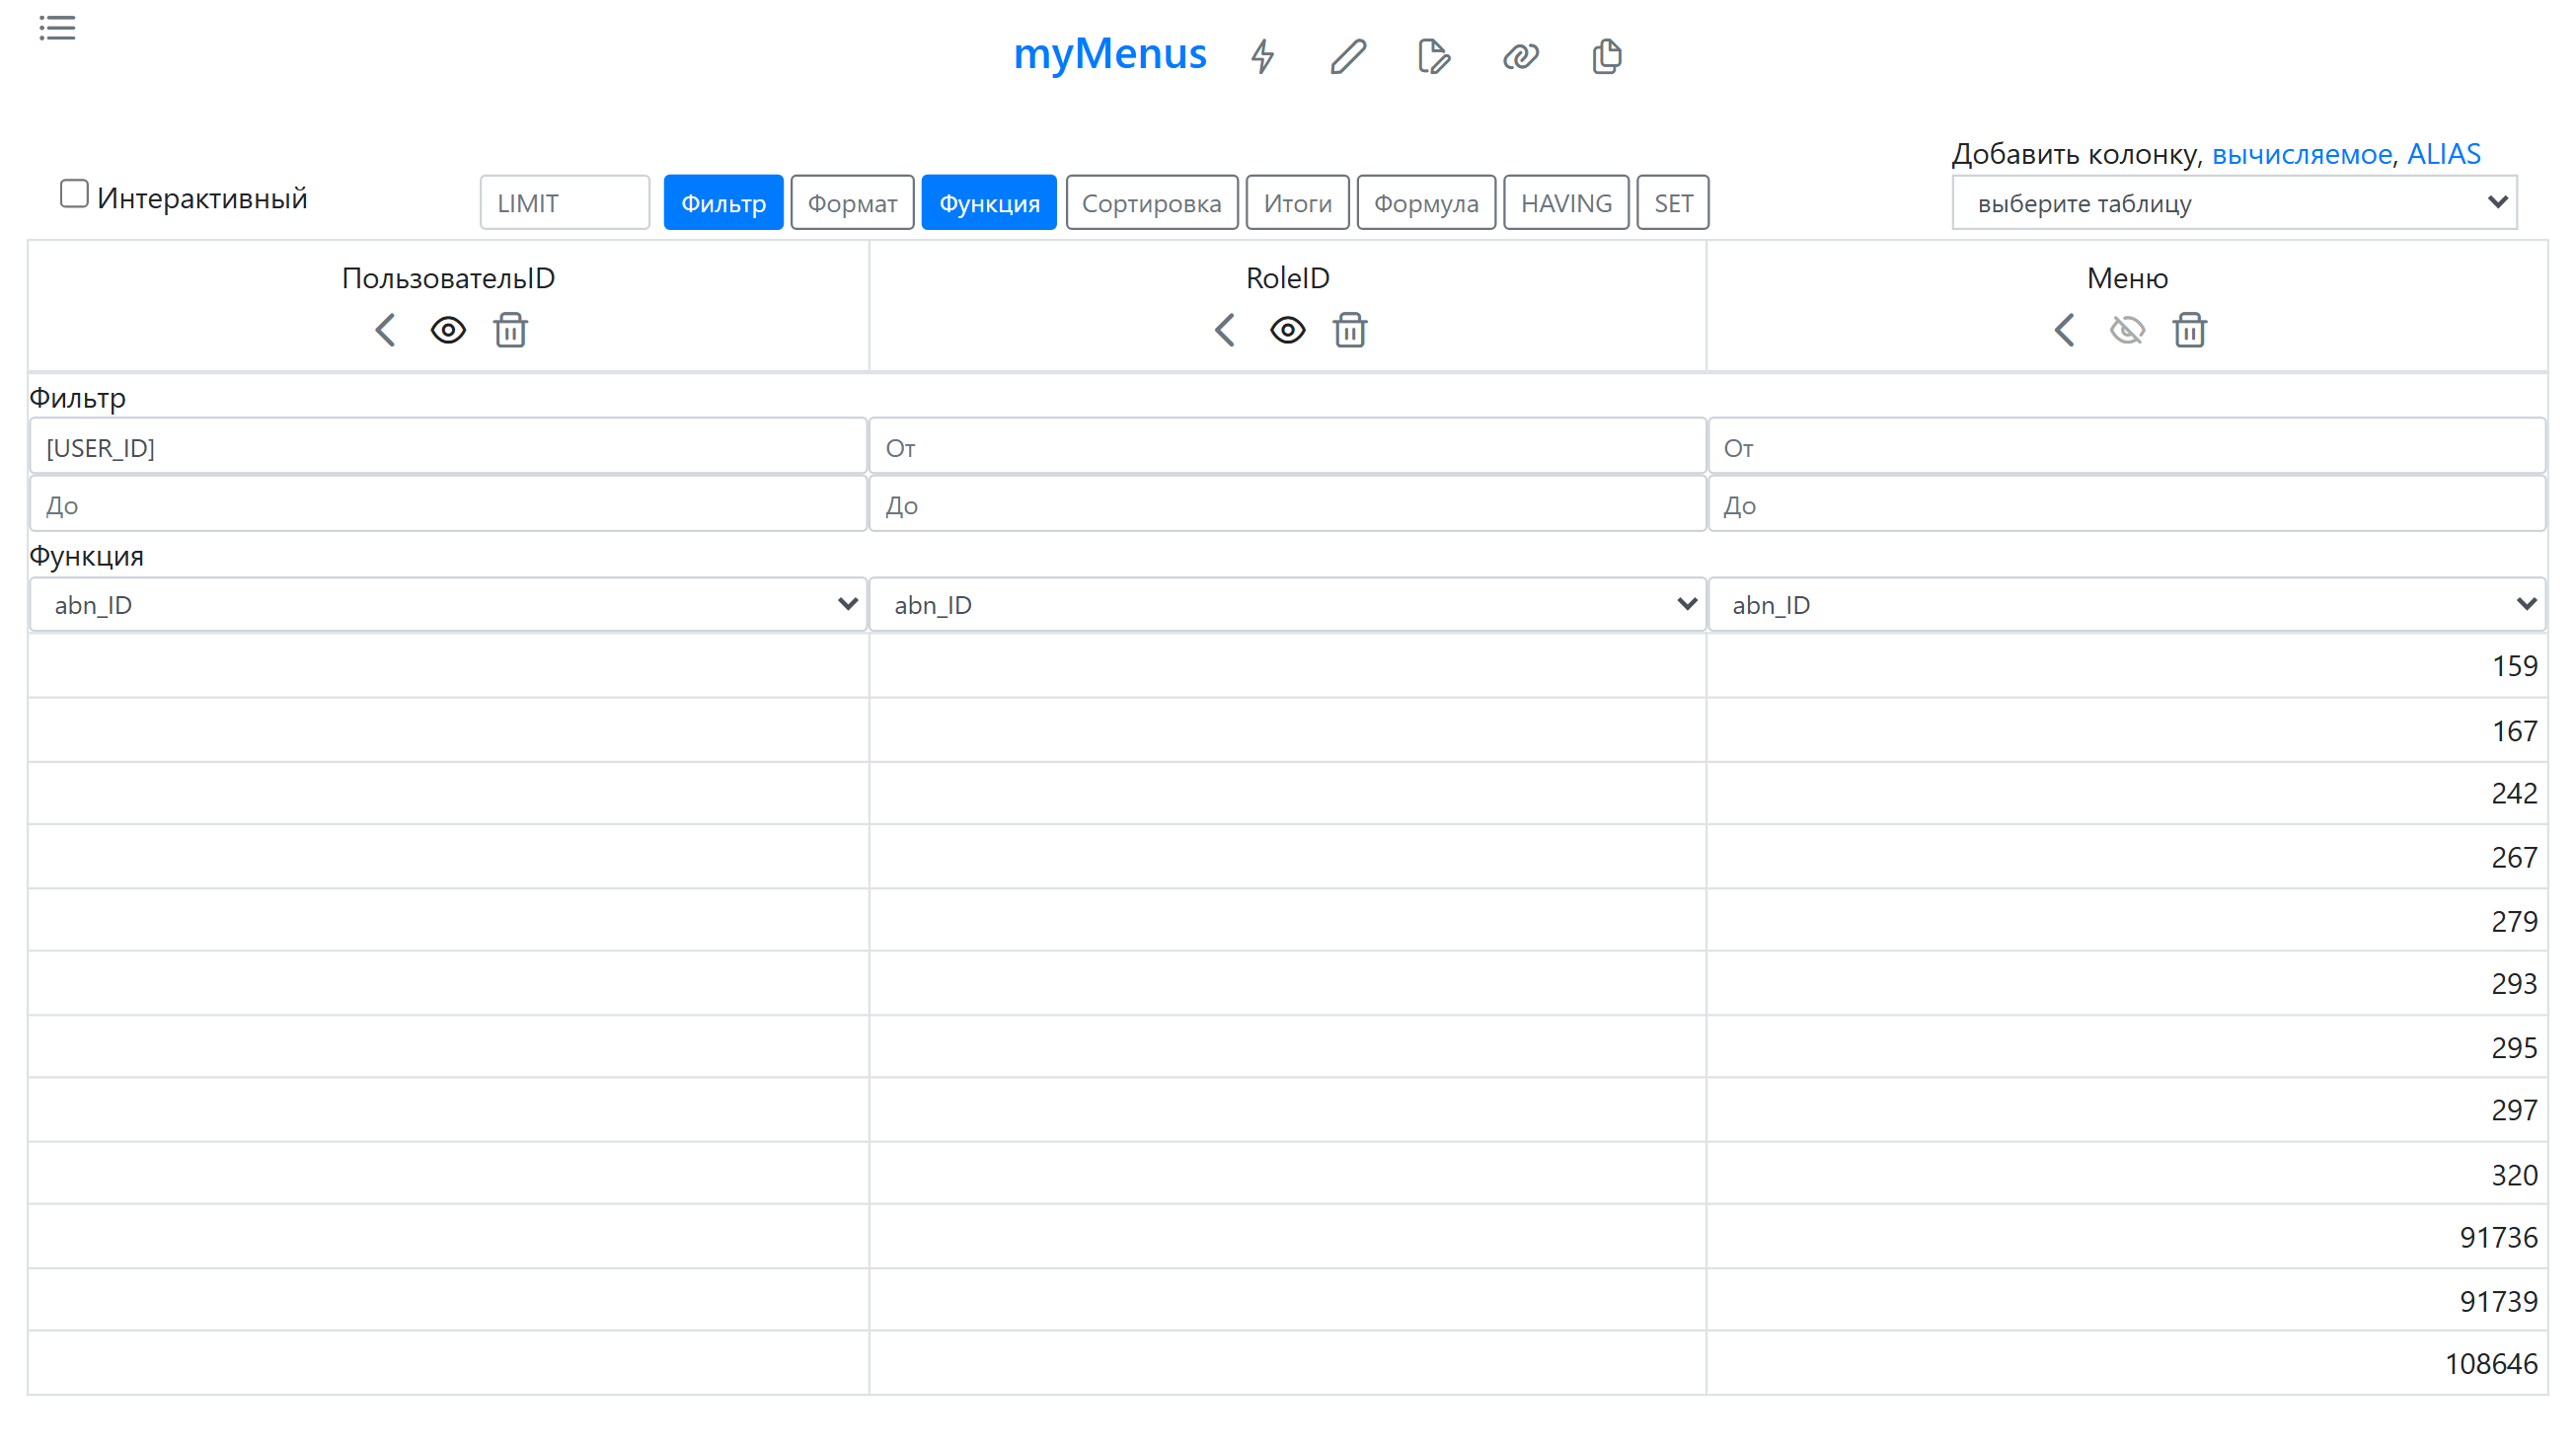
Двенадцать пунктов — те, что явно выданы ролям пользователя.
rec — собственно рекурсия. Одна-единственная колонка: источник — таблица «Меню», «Значение (от)» — [myMenus], «Функция» — RECURSIVE. Всё. Вот как это выглядит в конструкторе — весь запрос целиком:
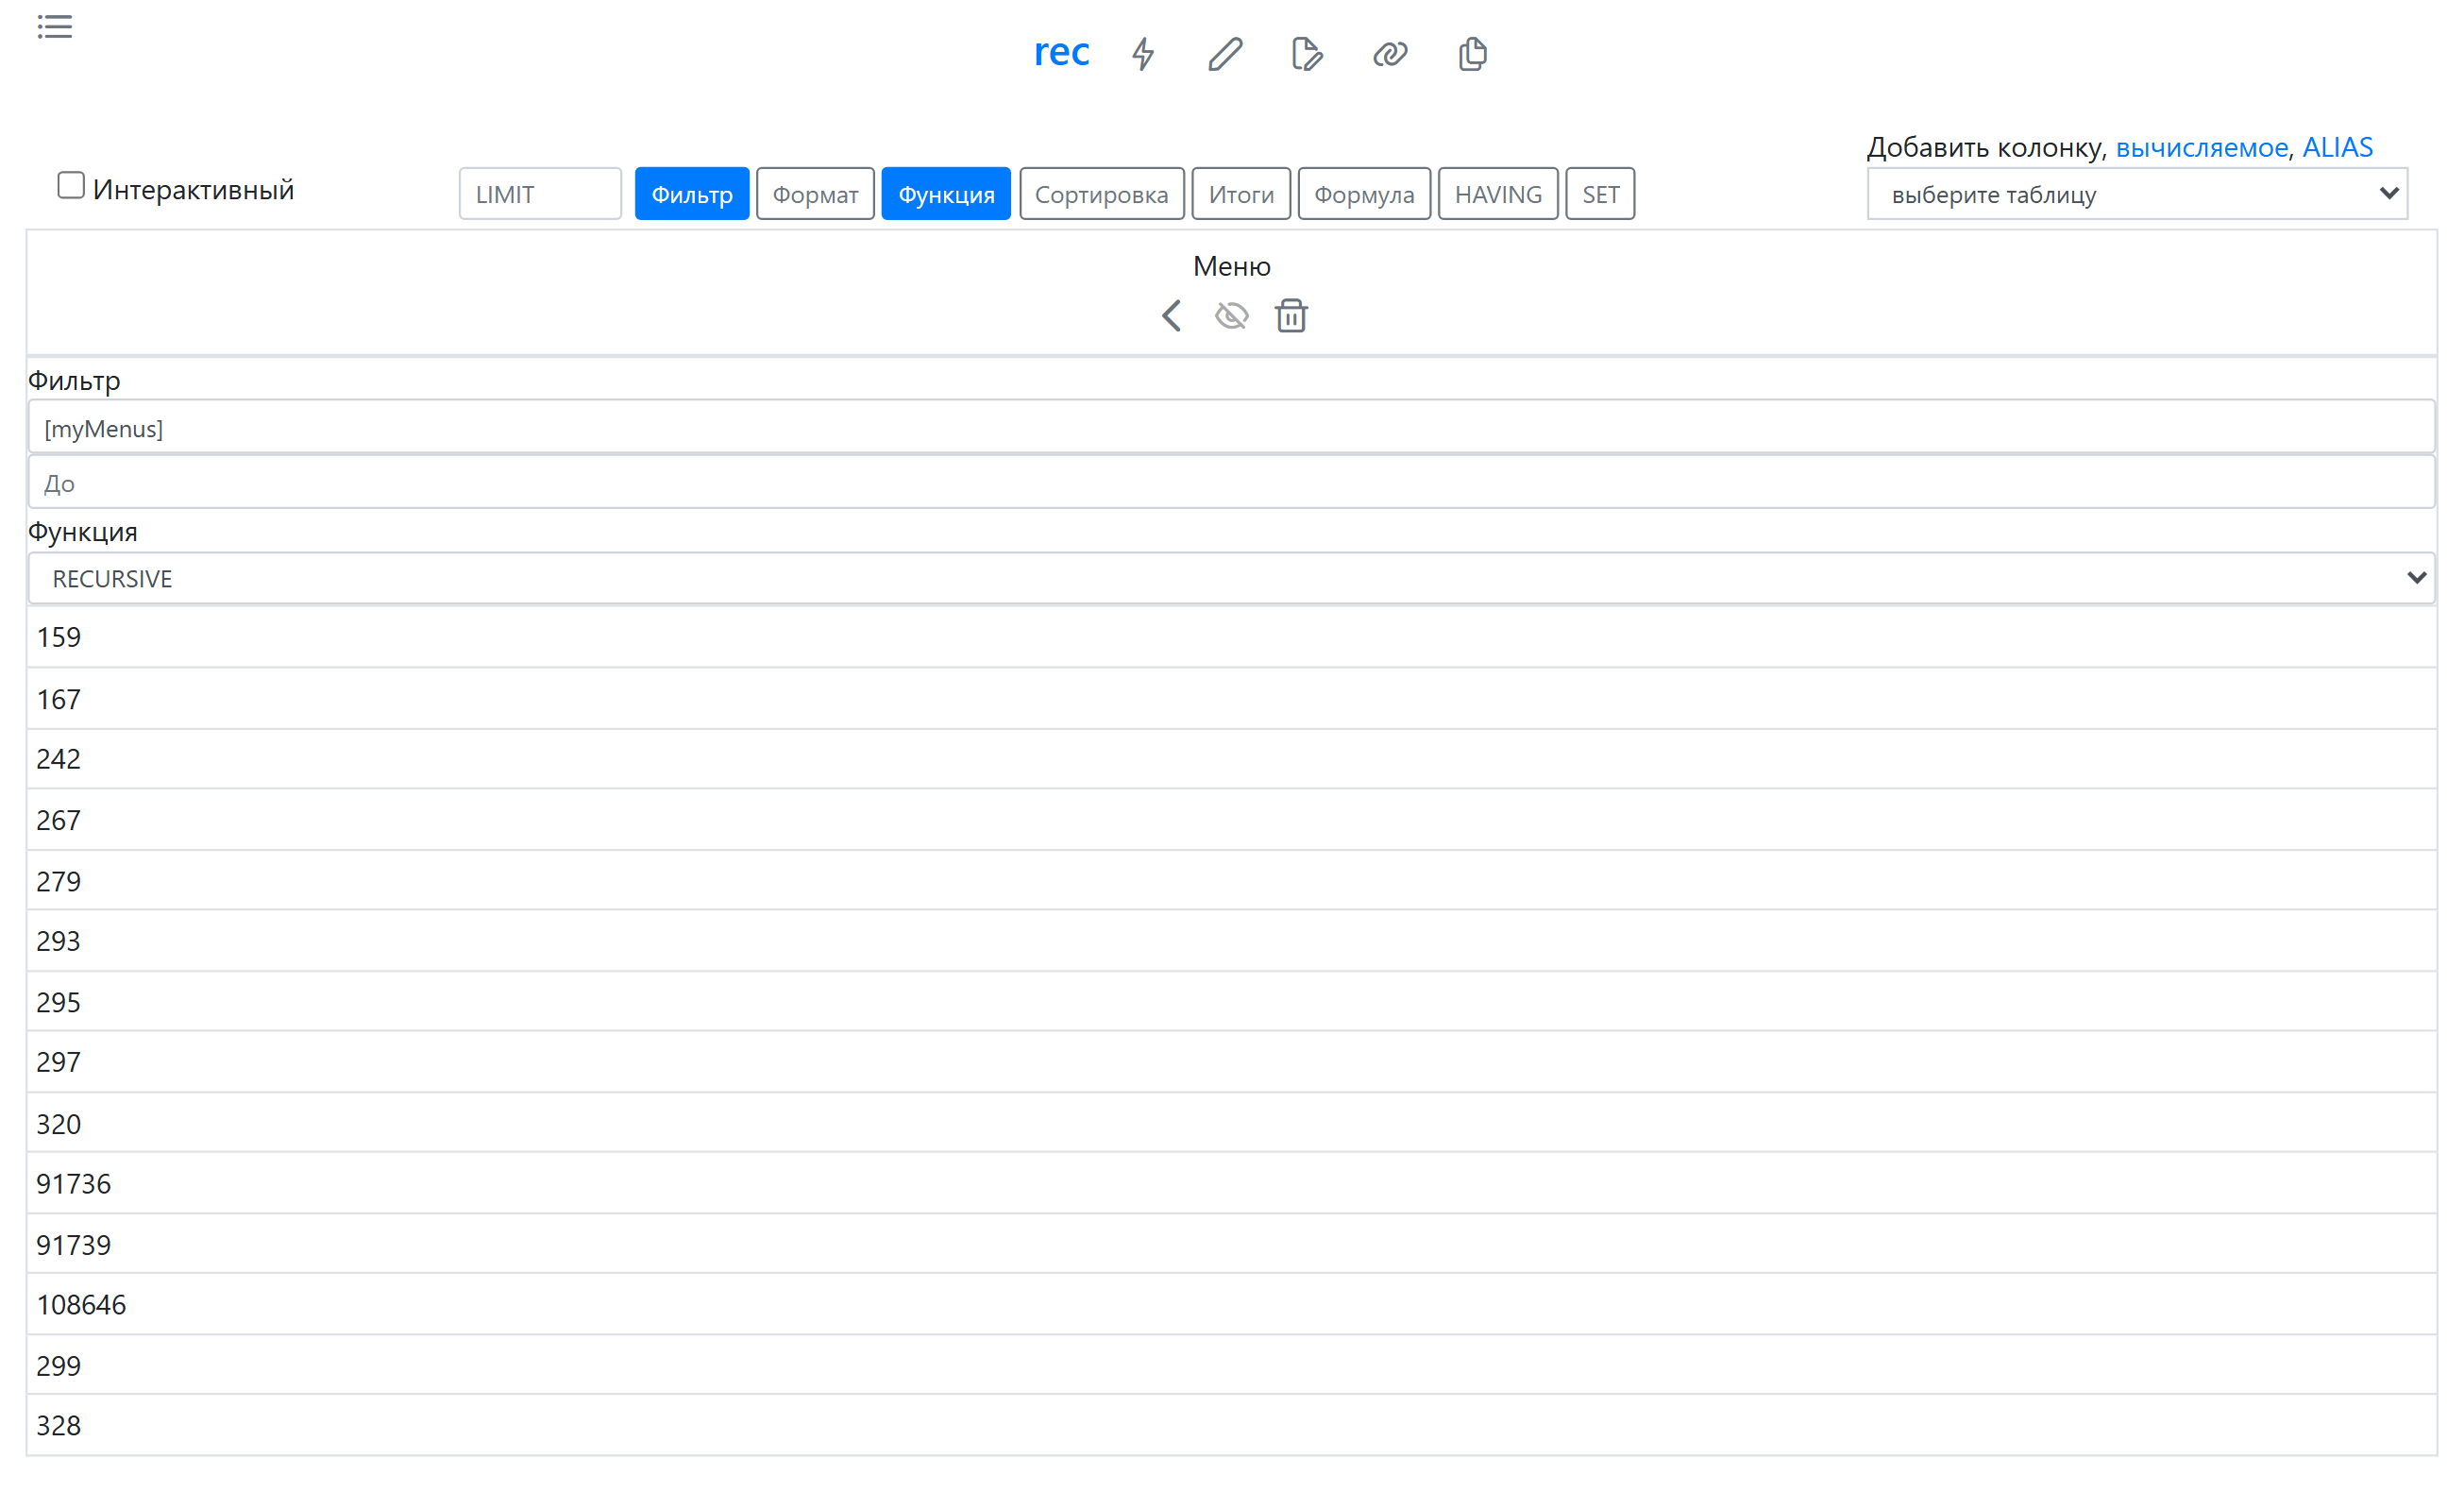
Два поля — [myMenus] в фильтре и RECURSIVE в функции — и движок собирает CTE из варианта А выше. В результате уже 14 строк вместо двенадцати: появились 299 («Задачи») и 328 («Мои карты») — дети пункта 320 («ОРГАНАЙЗЕР»), который был в зерне. Роли выдали раздел — рекурсия добрала всё, что внутри него, на любую глубину.
MyRoleMenu — витрина. Обычный запрос над «Меню» с колонками name, menu_id (abn_ID), menu_up (abn_UP), href, icon и сортировкой по abn_ORD:
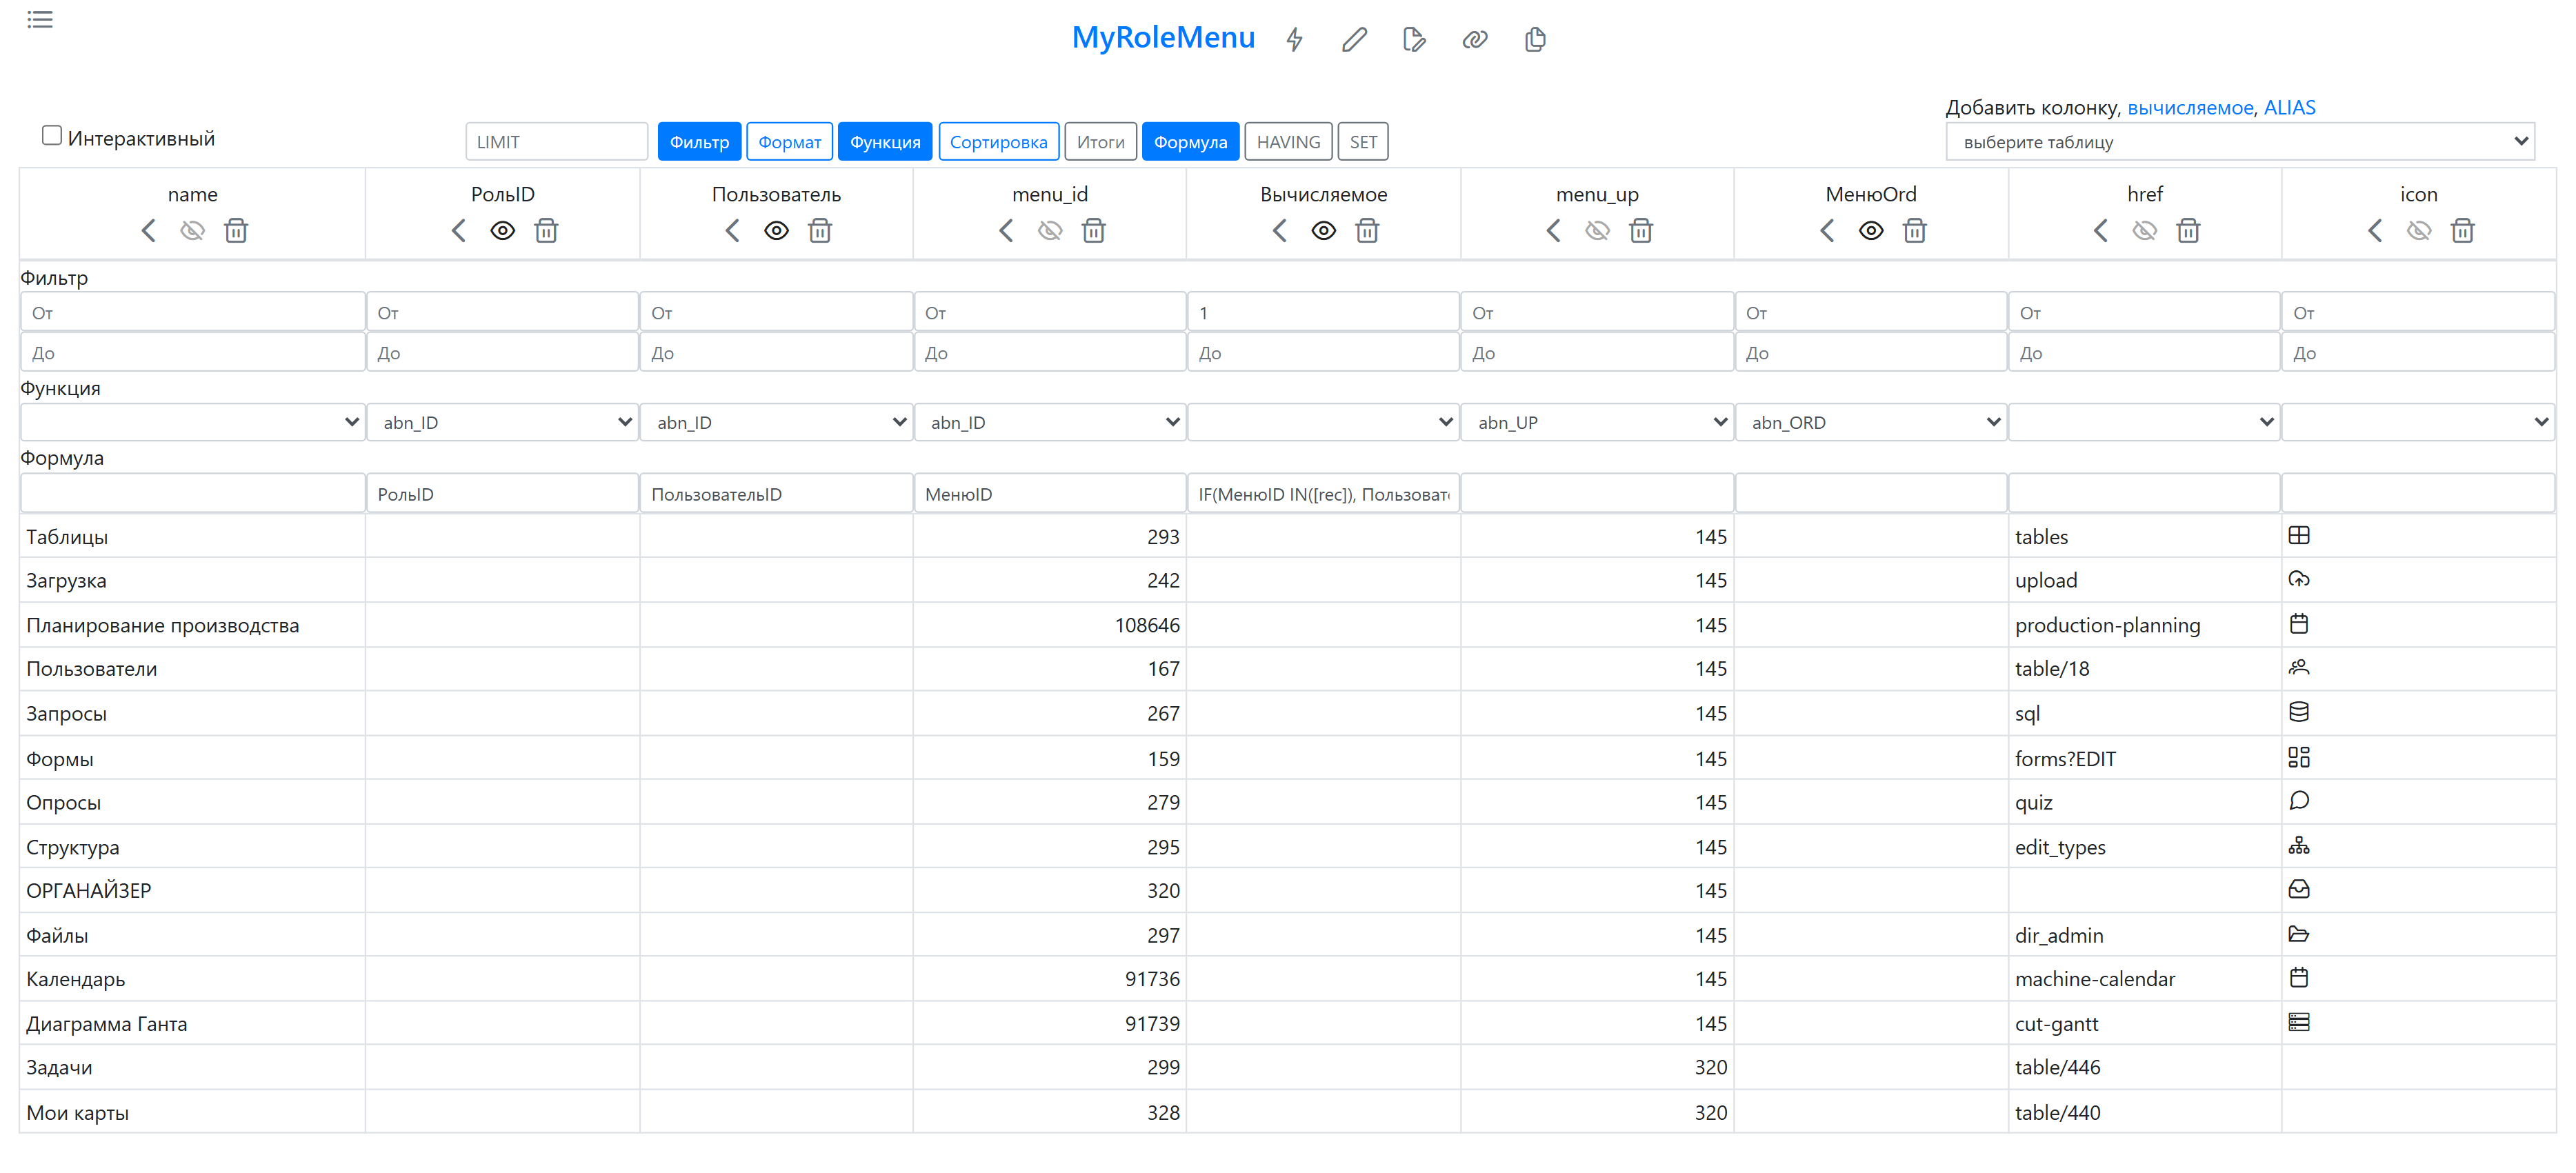
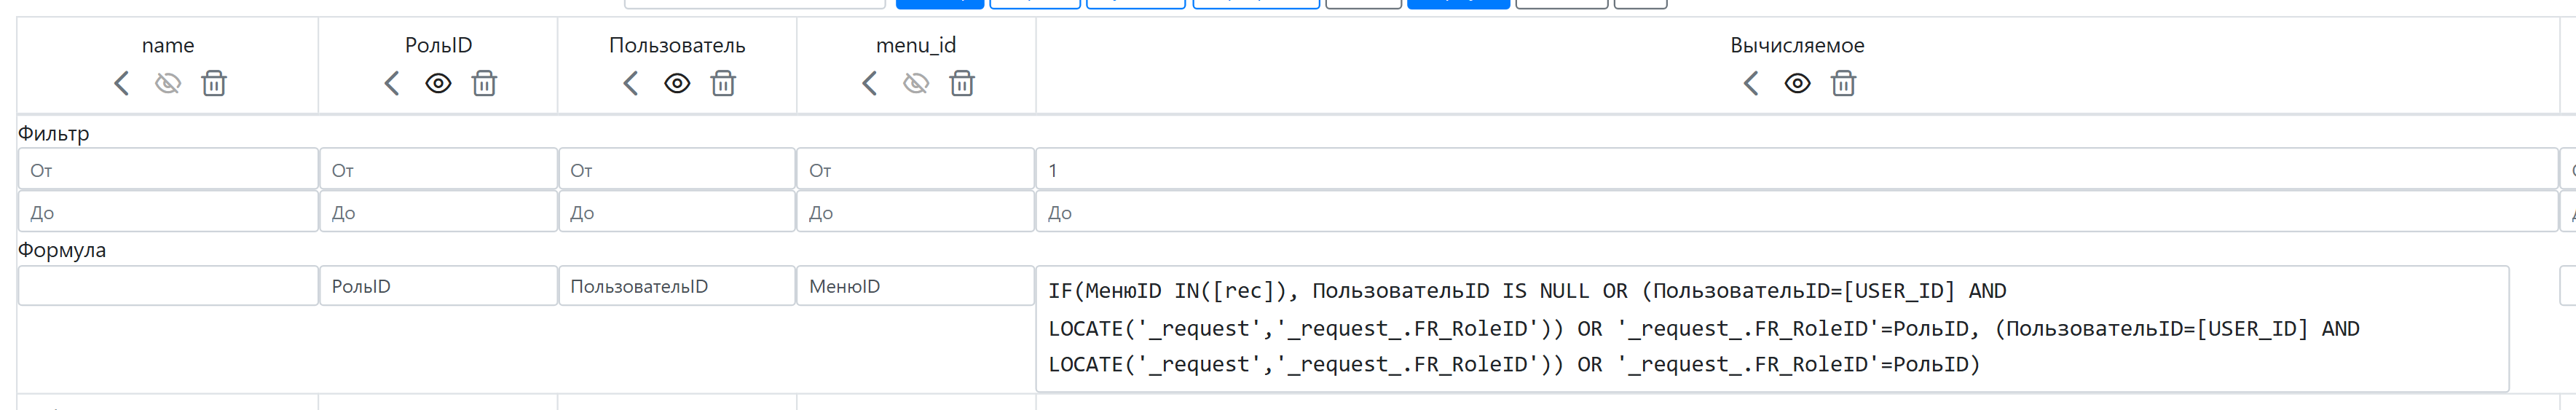
Отбор делает вычисляемая колонка: в поле «Формула» — вызов рекурсивного запроса через IN([rec]), в поле «Значение (от)» — 1, то есть строка попадает в ответ, только если выражение истинно.
Результат — готовый JSON для отрисовки меню:
[{"name":"ОРГАНАЙЗЕР","menu_id":"320","menu_up":"145","href":"","icon":"<i class=\"pi pi-inbox\"></i>"},
 {"name":"Задачи","menu_id":"299","menu_up":"320","href":"table/446","icon":""}]
Фронтенду остаётся сложить плоский список в дерево по menu_up. Ни одного дополнительного обращения к серверу: MyRoleMenu → rec → myMenus разворачиваются в один SQL — вот он, из того же trace.log, с рекурсивной частью, свёрнутой для читаемости:
SELECT a151.val 'name', a151.id 'menu_id', a151.up 'menu_up',
       a153.val 'href', a391.val 'icon'
  FROM ateh a151
  LEFT JOIN ateh a42 ON a151.up=a42.id AND a42.t=42
  LEFT JOIN (ateh r18 CROSS JOIN ateh a18 USE INDEX (PRIMARY))
         ON r18.up=a18.id AND a42.id=r18.t AND r18.val='115' AND a18.t=18
  LEFT JOIN ateh a153 ON a153.up=a151.id AND a153.t=153
  LEFT JOIN ateh a391 ON a391.up=a151.id AND a391.t=391
 WHERE a151.up!=0 AND a151.t!=a151.up AND length(a151.val)!=0 AND a151.t=151
   AND IF(a151.id IN(( WITH RECURSIVE c AS ( …весь рекурсивный запрос выше… )
                       SELECT DISTINCT id 'Меню' FROM c )),
          a18.id IS NULL OR (a18.id=462 AND …) OR …,
          (a18.id=462 AND …) OR …) = '1'
 ORDER BY CAST(a42.id AS DOUBLE) DESC, CAST(a151.ord AS DOUBLE)
Тот же приём работает для любой предметной иерархии: «показать все заказы по всем дочерним филиалам», «свернуть и развернуть категорию со всем вложенным» — без ручных джойнов на каждый уровень и без потолка «только два-три уровня вглубь».
Кейс 2. Графы: память по смыслу
Связи бывают не древовидными, а сетевыми — «похоже на это». На этом построен наш эксперимент IME (Integram Memory Engine): дать приложению память по смыслу прямо в рабочей базе, без отдельной векторной СУБД.
Идея в трёх шагах. Текст превращается в вектор — набор чисел, у похожих по смыслу текстов наборы похожи. Близость векторов (косинус) считает обычный отчёт Интеграма. А чтобы не сравнивать запрос с миллионами записей, у каждой записи хранятся ссылки на несколько ближайших соседей — получается граф «знакомств», и поиск идёт по нему прыжками: спроси соседа, кто ещё ближе к теме.
Вот здесь рекурсия и решает. Раньше обход графа шёл из клиента: около 82 обращений к серверу, примерно 33 секунды на один поиск. Рекурсивный отчёт собирает окрестность графа (поиск вширь до заданного бюджета) и ранжирует её косинусом в одном запросе: зерно → рекурсивное расширение → косинус → top-k.
Устроено это той же композицией из трёх запросов, что и меню, — меняется только шаг рекурсии (вариант Б: обход по ссылочному реквизиту вместо спуска по подчинённым таблицам):
nghbrs— зерно: прямые соседи стартовой записи, джойн по мультиссылке «сосед».recursion— одна колонка, «Значение (от)» =[nghbrs], «Функция» =RECURSIVE. Обход графа вглубь до бюджетаLIMIT.me_ann— витрина:SELECT label, <формула косинуса> WHERE id IN([recursion]) ORDER BY score DESC LIMIT k.
Сравните с меню: MyRoleMenu → rec → myMenus. Один и тот же скелет — «зерно → рекурсия → витрина с отбором по IN([…])».
| Способ обхода | Обращений к серверу | Время |
|---|---|---|
| обход из клиента | ~82 | ~33 с |
| один рекурсивный запрос | 1 | ~0.3 с |
Это около 100× по времени. На живой базе ideav.ru/mem выигрыш индексного поиска над полным перебором растёт с объёмом: 2.1× при 60 записях → 12.7× при 5000, при точности recall@1 95–100%.
Честно про границы
Рекурсия снимает боль «обхода вглубь», но не превращает Интеграм в векторную СУБД:
- рекурсия — это сбор окрестности вширь до бюджета (
LIMITна шаге), а не жадный best-first с отсечением: качество результата зависит от того, насколько удачно выбрано зерно; - для миллисекундных задержек на больших корпусах выделенный ANN-индекс (FAISS, Qdrant, pgvector) всё равно быстрее по константе;
- нативного векторного индекса нет — близость считается сканом по тексту, и на больших объёмах он медленнее;
- инкрементальное сопровождение рёбер графа при каждой вставке мы пока не доказали — в прототипе граф строился пакетно.
Прямые аналоги, которые умеют и рекурсию, и вектора, — это Postgres с pgvector и Neo4j. На больших объёмах они мощнее, но это отдельная инфраструктура. Ценность подхода Интеграма не в самом примитиве WITH RECURSIVE, а в композиции: вектора, рёбра, рекурсия и косинус живут в одной таблице рядом с бизнес-данными — без новой базы и без бюджета сверху.
Что забрать с собой
Рекурсивные отчёты плюс композиция [имя] превращают связи в обходимые структуры: деревья — от корня до листа, графы — от записи к её соседям, и всё это одним серверным вызовом. Для иерархий это убирает ручные джойны по уровням; для «похоже на это» — открывает память по смыслу прямо внутри приложения.
Рецепт целиком умещается в три строки:
- отдельный запрос из одной колонки: источник — таблица или ссылка, «Значение (от)» —
[запрос-зерно], «Функция» —RECURSIVE; - запрос-зерно, отдающий один столбец ID (лишние колонки скрываются флагом «Скрыть»);
- запрос-витрина, который отбирает строки по
IN([имя_рекурсивного_запроса])и показывает то, что нужно пользователю.
Подробности и цифры — в репозитории эксперимента ideav/ime: на пальцах, прототип и результаты, сравнение с векторными СУБД.